Research Topic
説明可能AI
機械学習・深層学習に基づくコンピュータビジョンモデルは高い認識性能を示す一方で,どの特徴に基づいて判断したのかを人間が直接理解することは容易ではありません。特に産業分野では,汎用的な大規模モデルではなく,個別の検査・診断・認識タスクに特化し,画像のみで訓練された軽量な専用モデルが多く用いられており,その判断の信頼性をどのように確保するかが重要になります。私の研究では,このような実運用に近い画像ベースのAIモデルを対象に,予測結果を分かりやすく説明するだけでなく,モデルの出力に実際に影響した特徴を捉える「忠実な説明」を重視し,人が判定根拠を確認できるAIの実現を目指しています。
物体検出モデルに対する視覚的説明
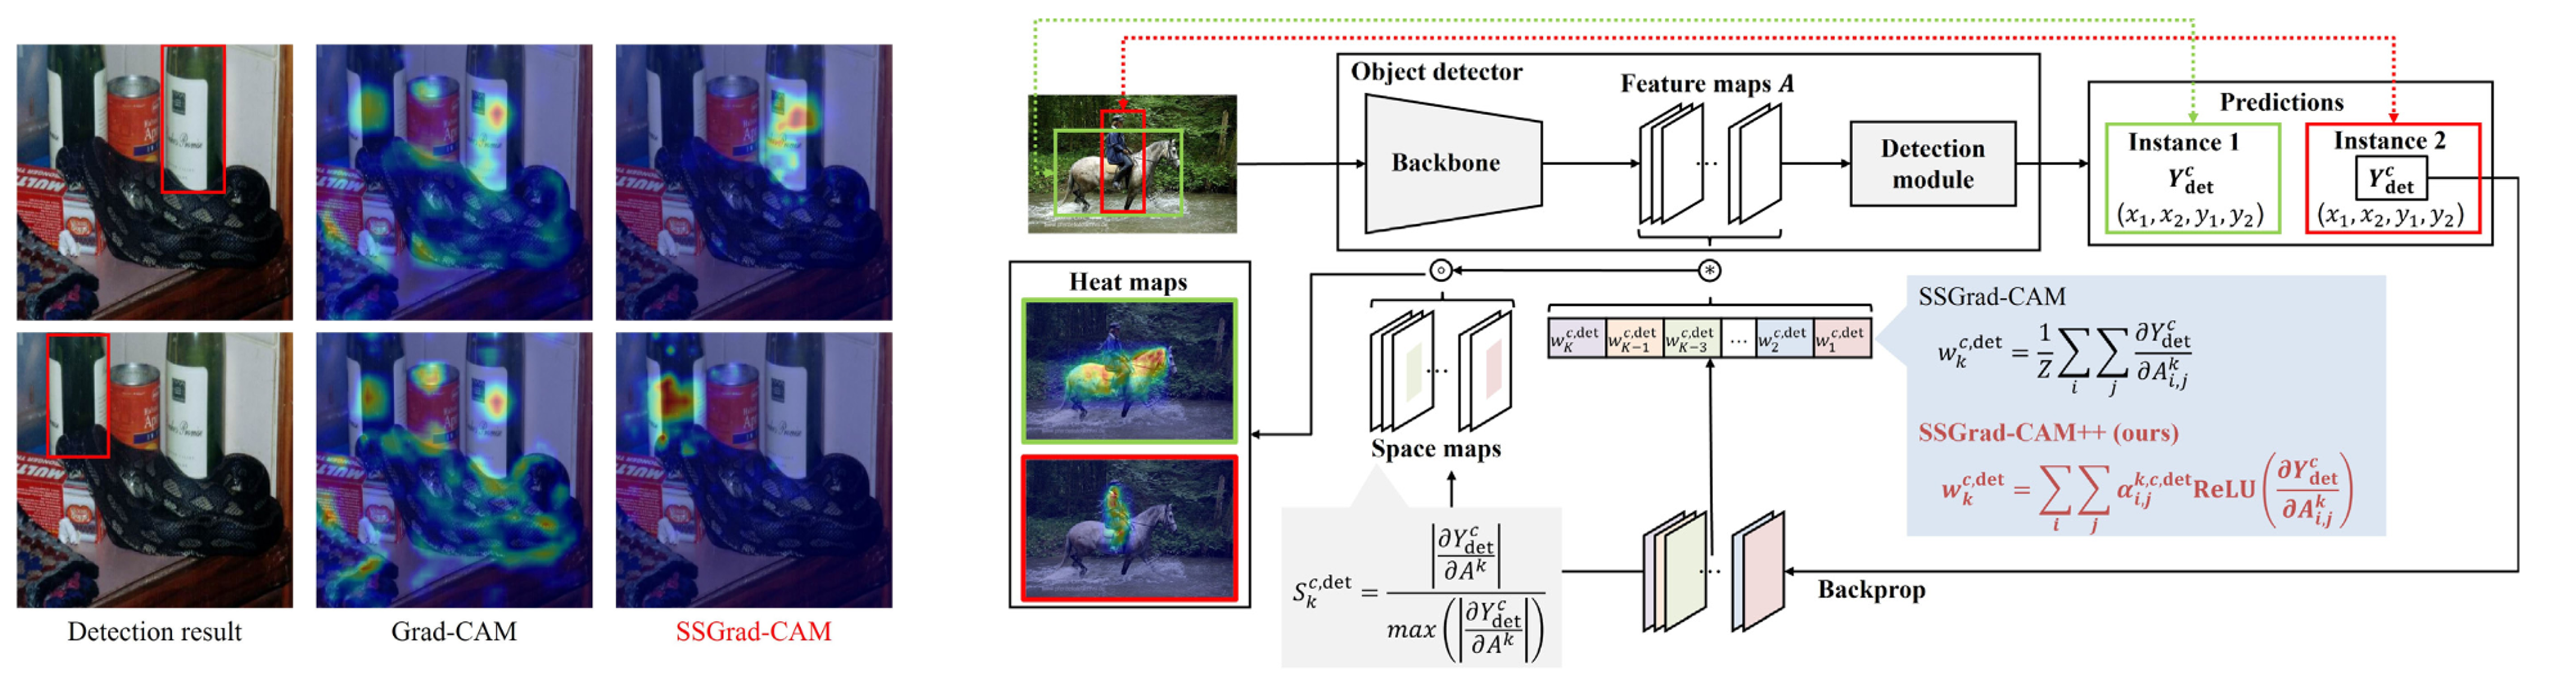
物体検出モデルに対しては,画像の中でどの領域が各検出結果に効いていたのかを可視化する研究を行っています。物体検出では,画像中の対象物の種類だけでなく,その位置も同時に推定します。そのため,分類モデル向けの説明手法をそのまま適用すると,検出された物体そのものではなく,背景や周辺領域,あるいは別の物体に強く反応した説明が得られてしまうことがあります。
この問題に対して,私の研究では,画像全体に対する説明ではなく,検出された一つ一つの対象に対応した説明を生成することを重視しています。具体的には,モデルが「何を検出したか」だけでなく,「どの位置のどの対象を根拠として検出したか」を反映するように重要領域を求めます。これにより,同じ画像内に複数の物体が存在する場合でも,それぞれの検出結果に対応した判断根拠を分離して可視化できます。
このような説明により,モデルが対象物の形状や外観に基づいて正しく判断しているのか,あるいは背景や周辺の文脈に依存しているのかを確認しやすくなります。特に,誤検出や見落としが発生した場合に,その原因を人間が分析し,モデルの改善や実環境での信頼性評価につなげることを目指しています。[ICIP 2022][IEEE Access 2025][CVPRW 2024][CVIU 2026]
関連論文
- Spatial Sensitive Grad-CAM++: Towards High-Quality Visual Explanations for Object Detectors via Weighted Combination of Gradient Maps · 2026Computer Vision and Image Understanding (CVIU), vol. 264, pp. 104658, 2026
- Spatial Sensitive Grad-CAM: Toward Instance-Specific Explanations for Object Detectors by Incorporating Spatial Sensitivity · 2025IEEE Access, vol. 13, pp. 202086-202102, 2025
ゲーム理論を活用した説明可能AI
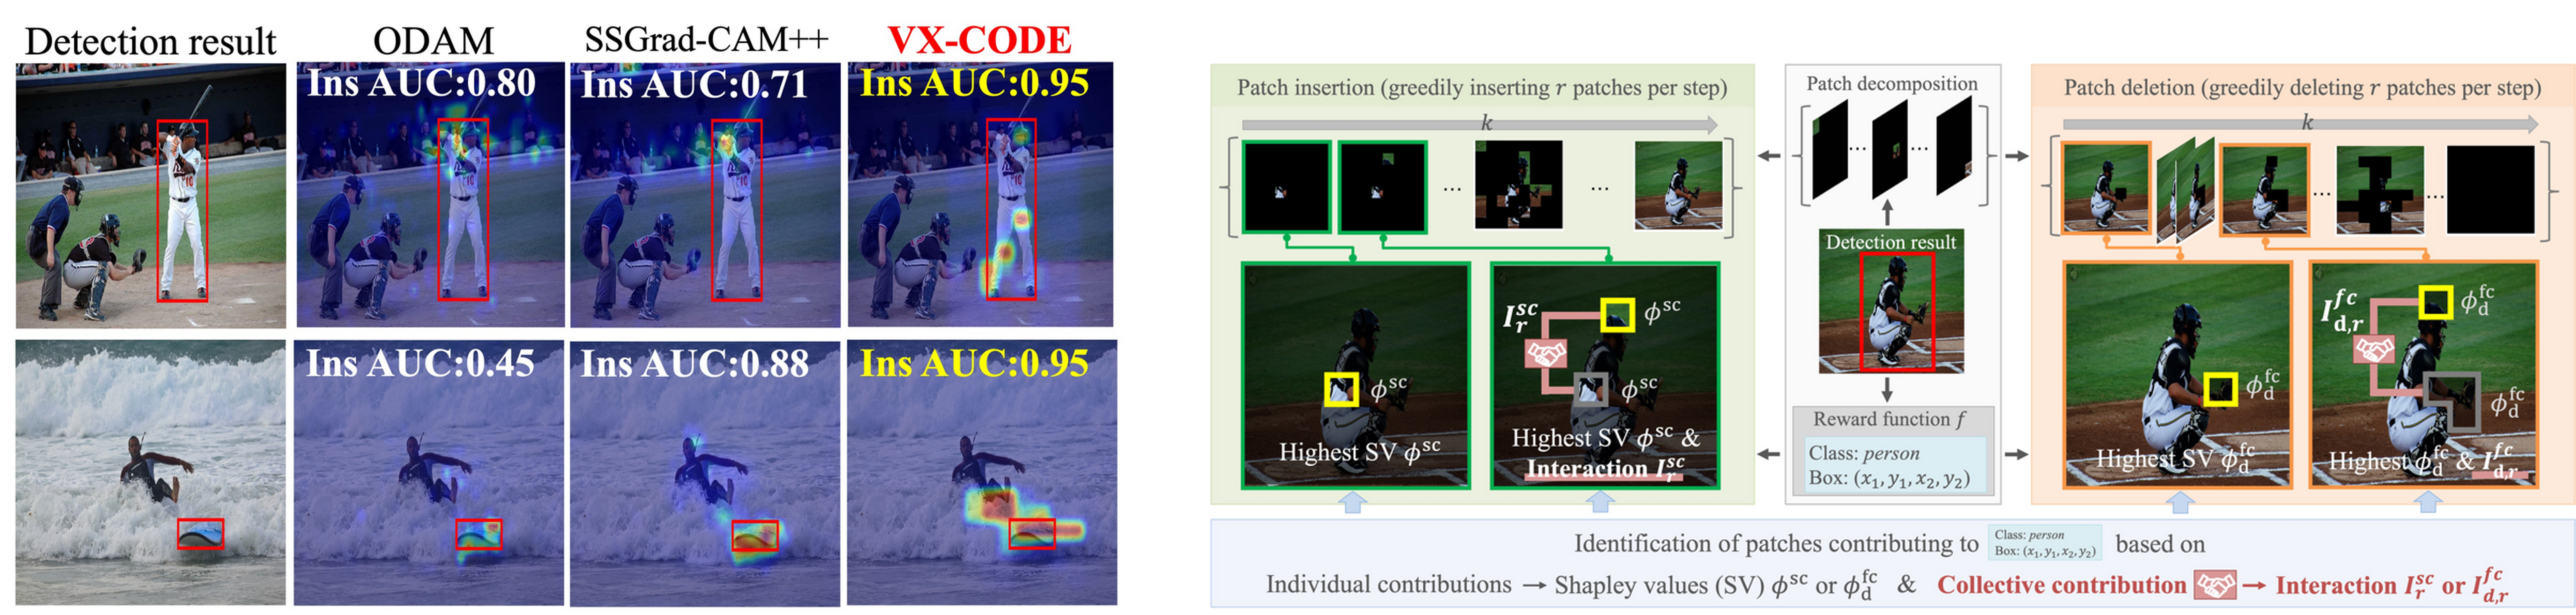
画像認識モデルの判断は,画像中の一つの目立つ領域だけで決まるとは限りません。対象物の一部,背景,周辺物体,色,形状,配置など,複数の領域が組み合わさることで初めて重要な手掛かりになる場合があります。例えば,ある領域だけを見ると判断への影響は小さくても,別の領域と同時に存在することで,モデルの予測を大きく変えることがあります。従来の単純な重要度マップでは,このような領域間の相互作用を十分に捉えることが難しいという問題があります。
この問題に対して,私の研究では,ゲーム理論の考え方を用いて,画像中の各領域がモデルの判断にどのように貢献しているかを分析します。特に,Shapley values に基づいて各領域の貢献度を評価し,さらに Interaction の考え方を取り入れることで,単独の領域の重要性だけでなく,複数領域の組み合わせが生み出す効果を捉えます。これにより,モデルが「どの部分を見ているか」だけでなく,「どの部分の組み合わせを手掛かりとして使っているか」まで説明できるようになります。
一方で,Shapley values や Interaction を画像全体に厳密に適用すると,考慮すべき領域の組み合わせが膨大になり,計算コストが非常に大きくなります。そこで,私の研究では,モデルの判断に強く関係する領域の組み合わせを効率的に探索することで,ゲーム理論に基づく高精度な説明を現実的な計算量で実現することを目指しています。これにより,従来のヒートマップでは見落とされやすい複雑な判断根拠を,より忠実に可視化できます。[CVPR Highlight 2026]
判断根拠の言語的説明
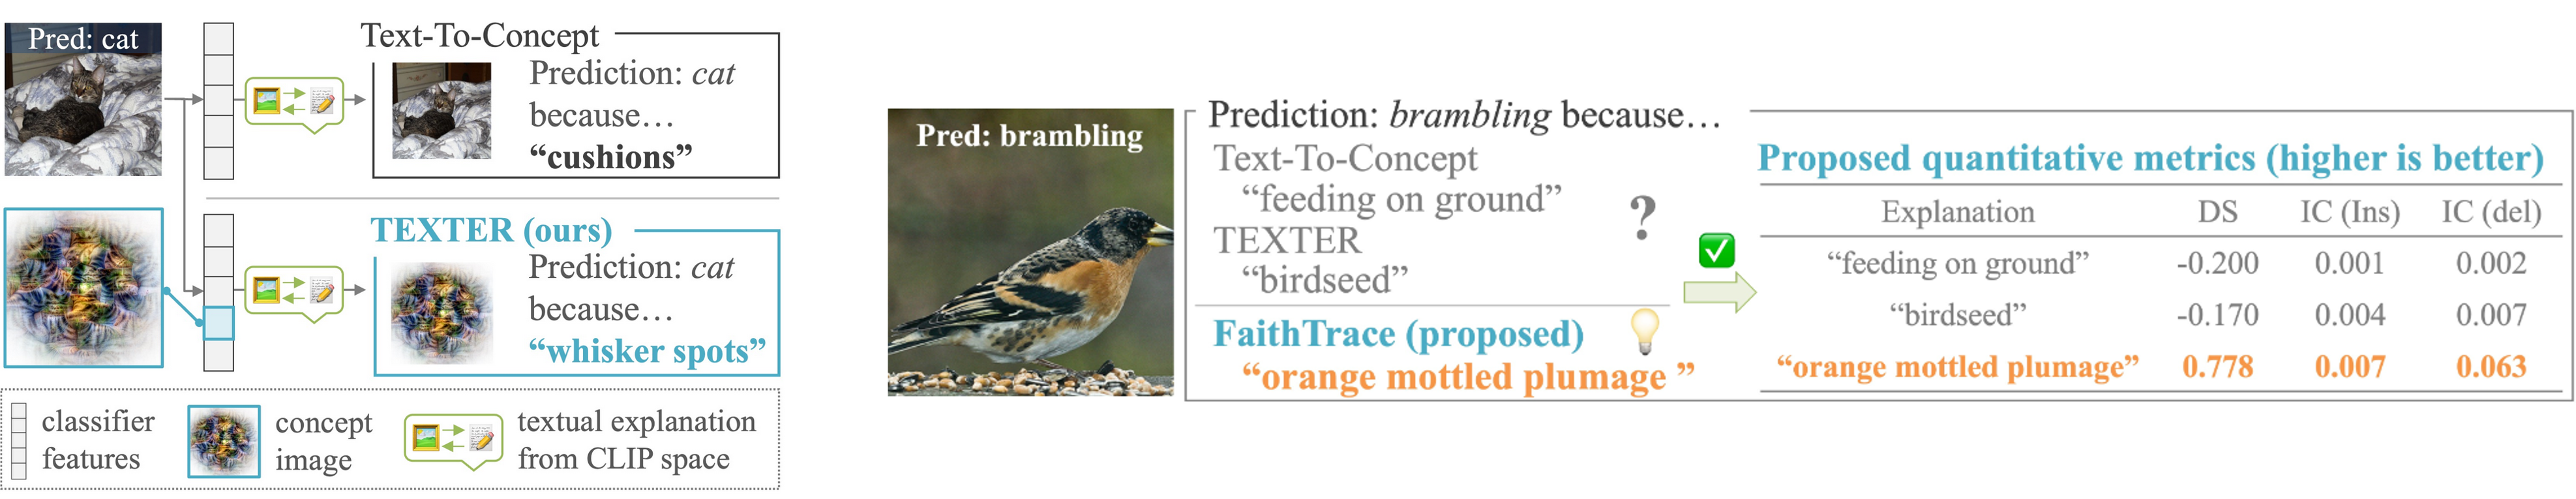
ヒートマップのような視覚的説明は,モデルが画像中のどの領域に注目したかを直感的に示すことができます。一方で,その領域の「何が」判断に効いていたのかまでは,人間が解釈する必要があります。例えば,同じ鳥の領域が強調されていても,モデルが羽の色を見ているのか,くちばしの形を見ているのか,背景の水辺を見ているのかは,ヒートマップだけでは明確に分かりません。
この問題に対して,私の研究では,モデルの判断に影響した視覚的特徴を自然言語で説明することに取り組んでいます。単に画像に写っている内容を説明するのではなく,モデルの予測を支えた特徴を言葉として表現することで,人間が「なぜそのクラスと判断されたのか」をより具体的に理解できるようにします。これにより,視覚的な説明だけでは分かりにくい,色,形状,部位,背景,文脈といった判断根拠を明示できます。
特に重視しているのは,もっともらしい説明文を生成することではなく,実際にモデルの出力に結びついた説明を得ることです。自然言語の説明は,人間にとって理解しやすい反面,画像の一般的な説明や,モデルの判断とは直接関係のない説明になってしまう危険があります。そこで,説明文がモデルの予測にどの程度影響する概念を表しているかを評価し,モデルの判断に忠実な自然言語説明を実現することを目指しています。[CVPR Findings 2026][arXiv 2026]
関連論文
- Zero-Shot Textual Explanations via Translating Decision-Critical Features · 2026Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR) Findings, pp. 3282-3292, 2026
- Zero-Shot Faithful Textual Explanations via Directional-Derivative Influence on Predictions · 2026arXiv:2605.16877, 2026